
Par Jean-Michel Huet , associé BearingPoint & Marouane Znagui, senior manager BearingPoint
Une transformation engagée mais encore incomplète
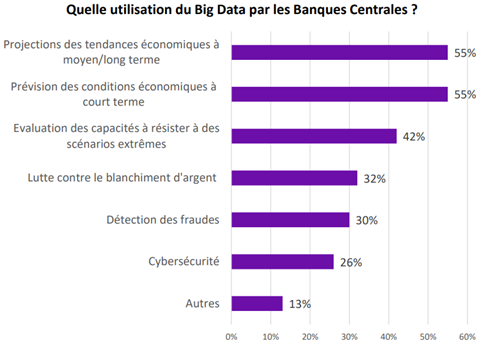
Au cours de la dernière décennie, les banques centrales africaines ont été confrontées à une transformation profonde de leur environnement. La diffusion des paiements électroniques, l’essor du mobile money et l’arrivée de nouveaux acteurs ont multiplié les volumes de données disponibles, tout en accélérant le rythme des échanges économiques. Dans le même temps, les attentes ont évolué: les décisions doivent être plus rapides, plus fines et davantage traçables, dans un contexte où les dynamiques économiques sont devenues plus complexes à anticiper. Dans ce cadre, la data et l’intelligence artificielle apparaissent comme des leviers majeurs.Elles permettent d’automatiser certains traitements, d’améliorer la qualité des analyses et de détecter plus tôt des signaux faibles.
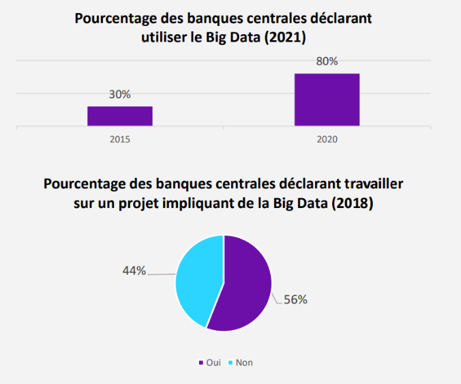
De nombreuses banques centrales ont ainsi engagé des expérimentations, souvent prometteuses. Ces initiatives ont démontré des gains réels, notamment en termes de réduction des délais ou de meilleure homogénéité des analyses.
Pourtant, un constat demeure : ces avancées restent difficiles à généraliser. Les solutions fonctionnent en phase pilote, mais peinent à s’inscrire durablement dans les processus. Le problème n’est pas technologique. Il tient aux conditions de mise en œuvre des données préparées de manière ad hoc, des chaînes de traitement instable et des responsabilités implicites. Autrement dit, l’enjeu n’est plus d’expérimenter, mais de construire une capacité institutionnelle durable.
Source: Irving Fisher Committee (2021)
Transformer les contraintes structurelles en leviers d’amélioration
Les banques centrales évoluent dans un environnement où certaines contraintes peuvent, à condition d’être maîtrisées, se transformer en véritables leviers. Les organisations restent largement structurées en silos métiers, ce qui favorise le développement d’expertises pointues mais limite encore la circulation de la donnée et la construction de visions transversales. Par ailleurs, malgré une abondance croissante de données, leur exploitation demeure complexe : une part importante du temps est encore consacrée à leur préparation et à leur consolidation, faisant de leur fiabilité dans la durée un enjeu central. À cela s’ajoute une concentration des expertises techniques au sein de certaines équipes seulement, ce qui fragilise les projets et souligne la nécessité d’une diffusion plus large des compétences pour renforcer la capacité collective. Dans le même temps, les exigences accrues de transparence imposent des analyses à la fois traçables et explicables, poussant à une structuration plus rigoureuse des données et à une formalisation des pratiques. Enfin, l’accélération des dynamiques économiques exerce une pression croissante sur les institutions, les obligeant à intégrer des données à haute fréquence tout en préservant la robustesse de leurs analyses. Ces contraintes ne sont pas seulement des freins : elles orientent la transformation vers une meilleure structuration et maîtrise de la donnée.
Des expérimentations probantes qui peinent à changer d’échelle
Les initiatives en matière de data et d’intelligence artificielle se sont progressivement imposées au sein des banques centrales, au point de produire aujourd’hui des premiers résultats tangibles. Les preuves de concept permettent de démontrer la faisabilité des solutions et de mobiliser les équipes autour de cas d’usage concrets. Elles peuvent automatiser certaines tâches, améliorer la cohérence des analyses ou traiter des volumes de données jusqu’alors difficiles à exploiter. Mais ces expérimentations reposent sur des conditions spécifiques. Les données sont préparées, les périmètres maîtrisés et les interventions humaines nombreuses. Cette situation ne reflète pas la réalité opérationnelle. Dès que l’on cherche à généraliser ces solutions, les limites apparaissent : hétérogénéité des données, instabilité des flux, absence de traçabilité ou difficulté d’appropriation par les métiers.
Le passage à l’échelle ne consiste donc pas à étendre un prototype. Il implique désormais un changement de nature. Les usages doivent être intégrés dans les processus, soutenus par des données fiables et inscrits dans un cadre organisationnel stable. Dans cette perspective, les preuves de concept doivent être repositionnées. Elles restent utiles, mais seulement si elles s’inscrivent dans une trajectoire de transformation plus large. Sans cela, elles produisent une accumulation d’initiatives sans impact durable.
La gouvernance de la donnée comme point de bascule
À mesure que les banques centrales intensifient leurs initiatives en matière de data et d’intelligence artificielle, les premiers résultats commencent à se matérialiser. Elle ne se limite pas à des règles techniques mais structure la capacité de l’institution à produire, exploiter et assumer ses données. Dans les banques centrales, les exigences de fiabilité et de traçabilité sont directement liées aux missions régaliennes. Pourtant, les données restent souvent fragmentées, peu documentées et gérées selon des pratiques souvent implicites. Cette situation est tolérable dans des processus manuels mais devient incompatible avec l’automatisation et l’intégration d’outils avancés.
La gouvernance permet de répondre à cette rupture. Elle consiste à définir des règles communes, à clarifier les rôles et à organiser les arbitrages. Elle rend explicite qui produit, qui valide et qui utilise les données. Lorsqu’elle est mise en place, elle permet de stabiliser les usages, d’améliorer leur reproductibilité et de sécuriser leur intégration dans les processus décisionnels. Elle devient ainsi une condition indispensable pour développer des usages d’intelligence artificielle crédibles et soutenables.
Des fondations opérationnelles pour rendre la transformation réelle
La gouvernance, si essentielle soit-elle, ne peut à elle seule suffire à rendre les usages pleinement effectifs. Le premier enjeu consiste à rendre les données réellement exploitables. Cela suppose de les définir, de les documenter et de les stabiliser dans le temps. Sans ce travail, chaque projet repose sur des retraitements spécifiques, ce qui empêche toute montée en charge. Le deuxième enjeu concerne l’industrialisation des chaînes de traitement. Dans de nombreuses institutions, les processus restent largement manuels, ce qui limite la fiabilité et la reproductibilité des analyses. Structurer ces chaînes permet de sécuriser les flux et de soutenir le développement des usages. L’automatisation constitue ensuite un levier central de création de valeur. Les gains les plus importants proviennent souvent de l’automatisation de tâches existantes plutôt que de déploiements d’IA sophistiquée. Elle permet de réduire les erreurs, d’accélérer les délais et de libérer du temps pour l’analyse. Enfin, les usages doivent être ancrés dans les processus métiers. Une solution ne crée de valeur que si elle s’intègre dans un fonctionnement organisationnel clair, avec des responsabilités définies et une appropriation par les équipes. Sans cela, elle reste périphérique et fragile.
Source: Irving Fisher Committee (2021)
Le passage à l’échelle : une question de cohérence globale
Les exemples internationaux montrent que le passage à l’échelle repose sur une combinaison de facteurs. Les institutions qui réussissent ne sont pas celles qui expérimentent le plus mais celles qui structurent leur environnement d’usage. Ces trajectoires reposent sur une logique commune :une gouvernance claire, des données structurées, des processus adaptés et une organisation capable de porter la transformation dans le temps. L’innovation technologique y joue un rôle, mais elle n’est jamais le facteur déterminant.
Le passage à l’échelle s’inscrit ainsi dans une trajectoire progressive. Les institutions sécurisent d’abord un socle minimal, développent ensuite une capacité collective et étendent progressivement les usages à partir de cas maîtrisés. La transformation ne repose pas sur une rupture, mais sur une accumulation cohérente.
De projets visibles à une capacité réelle
Les banques centrales disposent aujourd’hui des outils et des cas d’usage nécessaires pour engager leur transformation. Pourtant, la majorité des initiatives reste encore limitée par l’absence de conditions permettant leur déploiement à l’échelle. La transformation portée par la data et l’IA est d’abord institutionnelle. Elle repose sur la manière dont les données sont produites, structurées et intégrées dans les processus. Les preuves de concept démontrent un potentiel, mais seule la combinaison d’une gouvernance solide et de fondations opérationnelles robustes permet de créer une valeur durable. La différence ne se joue pas dans la sophistication des technologies mais dans la capacité à structurer et organiser leur usage. C’est à cette condition que la data et l’intelligence artificielle peuvent devenir des leviers structurants au service des missions des banques centrales.